คู่มือ Auto-Clustering สำหรับ ฐานข้อมูล
คู่มือนี้เรียบเรียงสำหรับ Ruk-Com PaaS หน้าจอและตัวเลือกอาจแตกต่างตามเวอร์ชันและสิทธิ์ของบัญชี
ตรวจสอบ Environment, Region, สิทธิ์บัญชี และสำรองค่าปัจจุบันก่อนดำเนินการกับระบบจริง
คำสั่ง ชื่อเมนู พารามิเตอร์ และค่าตัวอย่างในกรอบ Code คงรูปแบบตามระบบเพื่อให้คัดลอกและตรวจสอบได้ถูกต้อง
MariaDB/MySQL/Percona การทำคลัสเตอร์อัตโนมัติ
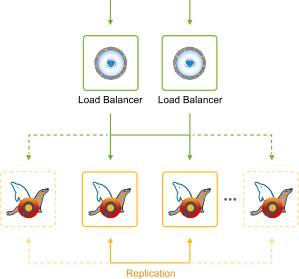
การจัดกลุ่มฐานข้อมูลเป็นข้อกำหนดบังคับสำหรับแอปพลิเคชันที่ใช้งานจริงที่มีโหลดสูงเพื่อให้มั่นใจว่าข้อมูลมีความพร้อมใช้งานและมีประสิทธิภาพสูงอย่างไรก็ตามการกำหนดค่าคลัสเตอร์ที่เชื่อถือได้นั้นไม่ใช่เรื่องเล็กน้อยแม้แต่สำหรับนักพัฒนาและผู้ดูแลระบบที่มีประสบการณ์ก็ตามสำหรับการแก้ปัญหานี้แพลตฟอร์มได้แนะนำการทำคลัสเตอร์แบบสำเร็จรูปสำหรับ MariaDB/MySQL/Percona เพื่อให้แอปพลิเคชันมีความพร้อมใช้งานสูงตามค่าเริ่มต้น
โซลูชันที่นำมาใช้ให้ประโยชน์หลายประการ:
- ความพร้อมใช้งานสูงพร้อมตัวเลือกการจำลองแบบที่กำหนดไว้ล่วงหน้า- ระดับ Primary-Secondary, ระดับ Primary-Primary, Galera, XtraDB
- ความสามารถในการปรับขนาดและการค้นพบอัตโนมัติ– Node ใหม่เพิ่มเข้ามาในระหว่างมาตราส่วนแนวนอนเชื่อมต่อกับคลัสเตอร์โดยจะมีการปรับที่จำเป็นทั้งหมดโดยอัตโนมัติ
- โหลดบาลานซ์อย่างมีประสิทธิภาพ– แต่ละคลัสเตอร์ได้รับการเสริมด้วย Node ProxySQL สอง Node สำหรับการทำโหลดบาลานซ์ด้วยการแยกคำขออ่าน/เขียนโดยอัตโนมัติ
- Failover อัตโนมัติ– Node ฐานข้อมูลที่ไม่พร้อมใช้งานชั่วคราวหรือมีเวลาแฝงสูงจะถูกแยกออกจากคลัสเตอร์โดยอัตโนมัติและเพิ่มอีกครั้งเมื่อการเชื่อมต่อได้รับการกู้คืน
เปิดใช้งานการจัดกลุ่มอัตโนมัติสำหรับฐานข้อมูล
คลิกที่Environment ใหม่ที่แดชบอร์ดแล้วเลือกMariaDB/MySQL/Perconaฐานข้อมูล
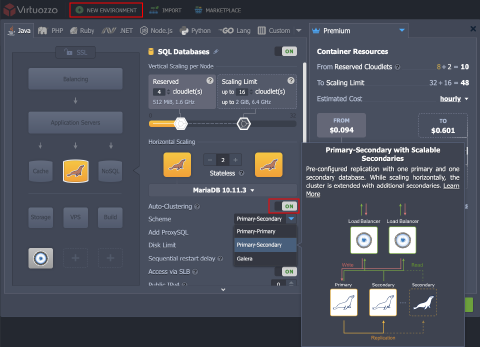 เปิดใช้งานการจัดกลุ่มอัตโนมัติปุ่ม. ด้วยเหตุนี้เมนูแบบเลื่อนลงที่มีรูปแบบการจำลองที่แตกต่างกันจะปรากฏขึ้น:
- MariaDB- Primary-Secondary, Primary-Primary และ Galera
- MySQL- Primary-Secondary และ Primary-Primary
- Percona- ระดับ Primary-Secondary, ระดับ Primary-Primary และ XtraDB
ตัวเลือกการจัดกลุ่มอัตโนมัติ
เลือกประเภทการจำลองที่คุณต้องการเพิ่มจำนวน Node ที่จำเป็น
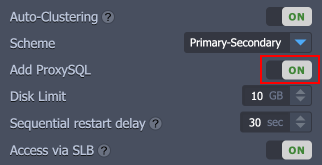
โหลดบาลานเซอร์ ProxySQL ที่พร้อมใช้งานสูง
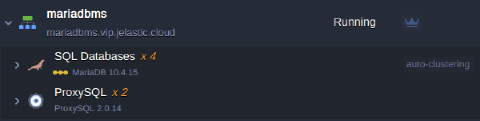
โซลูชันการทำคลัสเตอร์อัตโนมัติ MariaDB/MySQL/Percona แต่ละโซลูชันมี Node ProxySQL สอง Node ที่เปิดใช้งานตามค่าเริ่มต้นที่ด้านหน้าคลัสเตอร์ฐานข้อมูลหากจำเป็นคุณสามารถแยกพวกมันออกจากโทโพโลยีคลัสเตอร์ก่อนการติดตั้งด้วยสวิตช์ที่เกี่ยวข้องโปรดทราบว่าคุณจะไม่สามารถทำเช่นนั้นได้ในภายหลัง
ข้อมูลรับรองการเข้าถึงคลัสเตอร์ฐานข้อมูล
ในระหว่างการสร้างคลัสเตอร์แพลตฟอร์มจะสร้างข้อมูลรับรองการเข้าถึงฐานข้อมูลโดยอัตโนมัติแต่คุณสามารถแทนที่ข้อมูลเหล่านั้นด้วยข้อมูลของคุณเองได้ในสามขั้นตอนง่ายๆ:
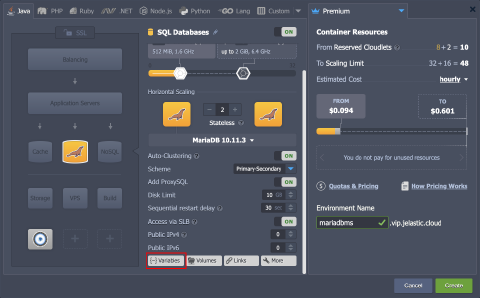
- คลิกที่ตัวแปรปุ่ม.
 2. จากนั้นกดเพิ่มเพื่อให้ข้อมูลรับรองฐานข้อมูลของผู้ใช้ที่กำหนดเองผ่านตัวแปรสองตัวDB_USERและDB_PASSดังต่อไปนี้:
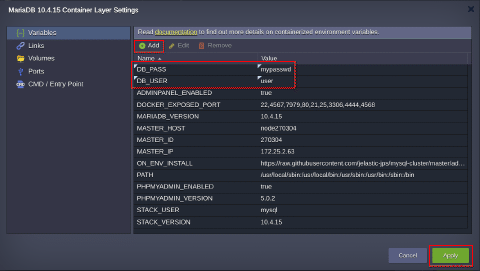 3. กดนำมาใช้และข้อมูลประจำตัวที่กำหนดเองจะถูกส่งถึงคุณเมื่อการติดตั้งคลัสเตอร์สำเร็จสำหรับการเข้าถึงPHP MyAdmin ที่ Node หลักและคลัสเตอร์ฐานข้อมูลจุดเข้า.
มาตราส่วนแนวนอนของคลัสเตอร์
หากคุณตัดสินใจที่จะขยายขนาดprimary-secondary/primary-primaryโทโพโลยีที่มี Node ฐานข้อมูลเพิ่มเติมจะถูกสร้างขึ้นโดยการโคลน Node รองที่มีอยู่เมื่อขั้นตอนการโคลนเสร็จสมบูรณ์ฐานข้อมูลบนสมาชิกคลัสเตอร์ใหม่จะจับข้อมูลผ่านทางบินล็อกเล่นซ้ำอัลกอริธึมดังกล่าวรับประกันว่า binlog จะไม่มีวันหมดอายุและการปรับขนาดแนวนอนจะใช้เวลาไม่นาน
การแยกเลเยอร์คลัสเตอร์
คุณอาจตัดสินใจว่าจะใช้แอปพลิเคชันภายนอกหรือไม่ขึ้นอยู่กับว่าคุณจะใช้แอปพลิเคชันภายนอกหรือไม่ชั้นคุณจะเปิดเผยภายนอก - ทั้งหมดหรือเลเยอร์พร็อกซีจุดเริ่มต้นเท่านั้นหมุนการเข้าถึง SLBสลับไปยังตำแหน่งที่ต้องการสำหรับแต่ละเลเยอร์แล้วคลิกสร้าง.
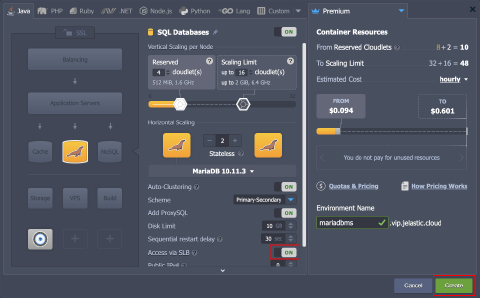 นั่นคือทั้งหมด! ไม่ต้องกำหนดค่าใดๆคลัสเตอร์ก็พร้อมใช้งานแล้ว
ข้อมูลการเข้าถึงคลัสเตอร์ฐานข้อมูล
หลังจากติดตั้งสำเร็จคุณจะได้รับอีเมลจำนวนหนึ่งพร้อมข้อมูลคลัสเตอร์:
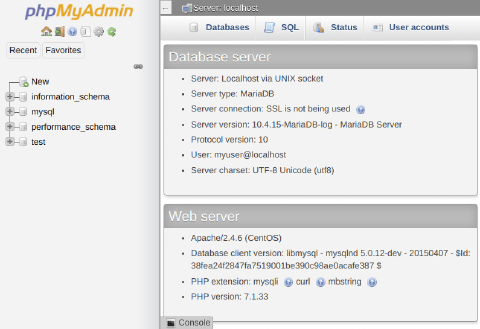
- PHP MyAdmin ที่ Node หลัก- อินเทอร์เฟซการดูแลระบบเว็บพร้อมข้อมูลประจำตัวในการเข้าถึงเซิร์ฟเวอร์ฐานข้อมูลสำหรับการจัดการเชิงโต้ตอบ
 *จุดเริ่มต้นสำหรับการเชื่อมต่อกับคลัสเตอร์ฐานข้อมูล-ชื่อโฮสต์และข้อมูลรับรองสำหรับการเชื่อมต่อแอปพลิเคชันไปยังคลัสเตอร์ฐานข้อมูล Node เหล่านี้สร้างชั้นพร็อกซีที่เรียกว่าจุดเริ่มต้นสำหรับคลัสเตอร์ฐานข้อมูลที่มีชื่อโฮสต์ดังต่อไปนี้:พร็อกซี.${envName}.${platformDomain}.
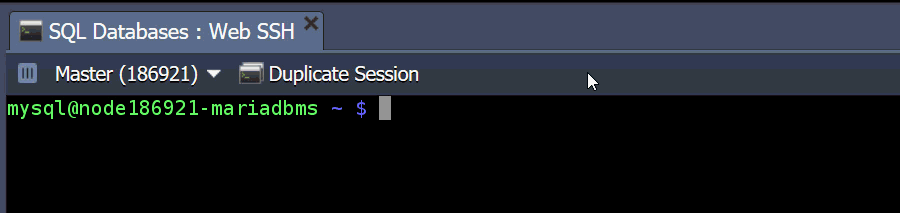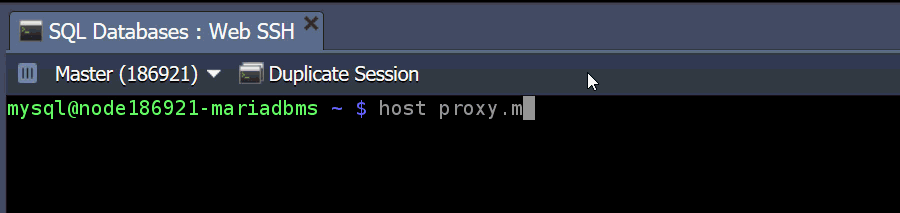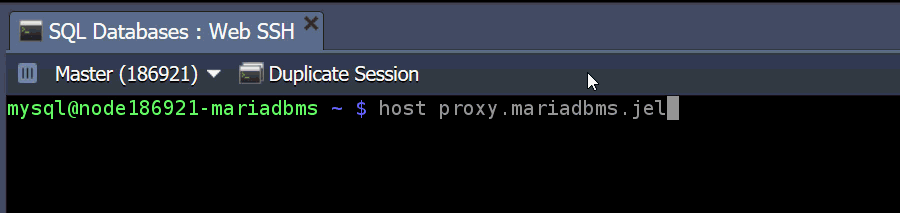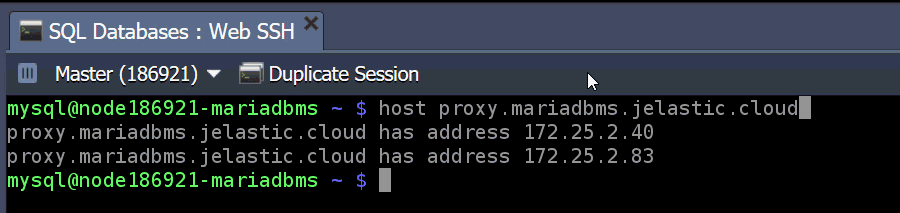
บันทึก:ในกรณีที่คุณกำลังจะสร้างและใช้บัญชีผู้ใช้แบบกำหนดเองหลังการติดตั้งคลัสเตอร์คุณควรเพิ่มบัญชีผู้ใช้เหล่านั้นลงในmysql_usersตารางบนแต่ละ Node ProxySQL ไม่เช่นนั้นคุณจะไม่สามารถสร้างการเชื่อมต่อกับฐานข้อมูลผ่านเลเยอร์พร็อกซีได้เมื่อต้องการทำเช่นนี้ให้ออกคำสั่งด้านล่าง:
$ MYSQL_PWD=admin mysql -h 127.0.0.1 -P6032 -uadmin -e "INSERT INTO mysql_users (username,password,default_hostgroup) VALUES ('<username>', '<password>', 2);"
$ MYSQL_PWD=admin mysql -h 127.0.0.1 -P6032 -uadmin -e "LOAD MYSQL USERS TO RUNTIME; SAVE MYSQL USERS TO DISK;"
ทดแทน<username>และ<password>ด้วยข้อมูลประจำตัวของบัญชีฐานข้อมูลที่สร้างขึ้นใหม่
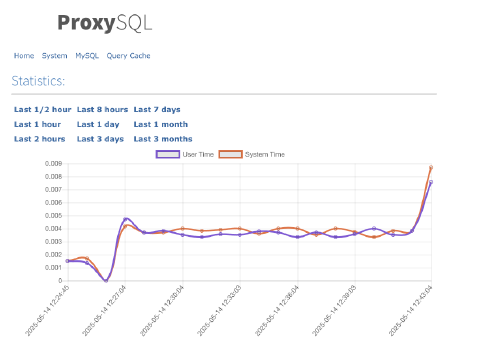
- แผงเว็บ ProxySQL- UI เว็บสำหรับสถิติระบบและตัวชี้วัดฐานข้อมูลช่วยในการแก้ไขปัญหาและการวิเคราะห์ประสิทธิภาพโดยมอบวิธีง่ายๆในการตรวจสอบสถานะของเซิร์ฟเวอร์ ProxySQL และแบ็กเอนด์ฐานข้อมูลรวมถึงสถิติการเชื่อมต่อประสิทธิภาพการสืบค้นและตัววัดอื่นๆ
ประเภทการจำลองแบบใดให้เลือก
มาพิจารณารายละเอียดเกี่ยวกับรูปแบบการจำลองแต่ละรูปแบบที่มีสำหรับฐานข้อมูลภายในแพลตฟอร์มเพื่อทำความเข้าใจว่ารูปแบบใดเหมาะสมที่สุดสำหรับความต้องการและกรณีการใช้งานเฉพาะ
การจำลองแบบ MariaDB/MySQL/Percona ระดับ Primary-Secondary
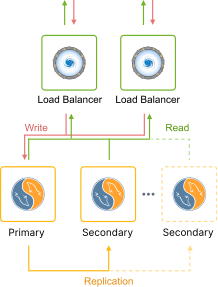
Primary-Secondaryการจำลองแบบเป็นโทโพโลยีที่ใช้บ่อยที่สุดซึ่งให้ความสอดคล้องที่ดี (นั่นคือมี Node เดียวในการแก้ไขข้อมูล) แต่ไม่มีการเปลี่ยนระบบอัตโนมัติเมื่อเกิดความล้มเหลวหลักเวลาแฝงในการเขียนในการจำลองแบบอะซิงโครนัสต่ำเนื่องจากการเขียนถูกบันทึกภายในเครื่องโดยเซิร์ฟเวอร์หลักก่อนที่จะเขียนไปยังเซิร์ฟเวอร์รองช่วยให้สามารถขยายการอ่านได้โดยให้ประสิทธิภาพสูงสุดเนื่องจากการเพิ่มเรพลิกาเพิ่มเติมจะไม่ส่งผลต่อเวลาแฝงของการจำลองอ่านเนื้อหารองได้โดยไม่มีผลกระทบกับเนื้อหาหลักโดยมีข้อดีที่ชัดเจนดังนี้:
- ประสิทธิภาพสูงสำหรับการร้องขอการอ่าน
- การสำรองฐานข้อมูลสามารถทำได้โดยไม่มีผลกระทบต่ออินสแตนซ์หลัก
- คำขอเชิงวิเคราะห์สามารถโหลดอินสแตนซ์รองได้เท่านั้น (โดยไม่กระทบต่อไพรมาตี)
การจำลองแบบ MariaDB/MySQL/Percona ระดับ Primary-Primary
Primary-Primaryการจำลองแบบอะซิงโครนัสทำงานกับ Node หลักสอง Node พร้อมกันเมื่อเปรียบเทียบกับโซลูชันหลัก-รองที่เป็นค่าเริ่มต้นจะได้รับประโยชน์จากการสร้างสมดุลของโหลดการเขียนและการกู้คืนที่ง่ายขึ้นเมื่อ Node หลักหนึ่งล้มเหลว
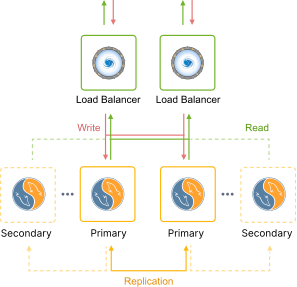
ตรงกันข้ามกับการตั้งค่าเริ่มต้นในการปรับขนาดคลัสเตอร์หลัก-หลักจะนำไปสู่การเพิ่มคลัสเตอร์รองเมื่อสร้างแล้วอินสแตนซ์รองจะมีการกระจายเท่าๆกันระหว่าง Node หลักซึ่งช่วยให้กระจายปริมาณงานการจำลองได้อย่างราบรื่นและเพิ่มจำนวนอ่านความจุของคลัสเตอร์
คลัสเตอร์ MariaDB Galera และ Percona XtraDB
คลัสเตอร์ Galera และ XtraDBโทโพโลยีคือการจำลองแบบซิงโครนัสหลายหลักที่ดำเนินการในเวลาที่ยอมรับธุรกรรมโดยการออกอากาศรายการเขียนที่ตั้งค่าให้กับ Node คลัสเตอร์ทั้งหมดเพื่อนำไปใช้พวกเขาตรวจสอบให้แน่ใจว่าการเขียนถูกส่งไปยัง Node ทั้งหมดในคลัสเตอร์ก่อนที่จะคอมมิตการเขียนนี้จริง
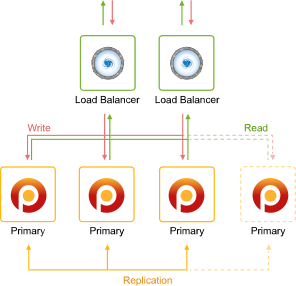
แอปพลิเคชันผู้ใช้สามารถส่งการอ่านและเขียนไปยัง Node ใดๆในคลัสเตอร์ที่ให้ความสามารถในการขยายขนาดธุรกรรมการอ่านและเขียนการเพิ่ม Node ลงในคลัสเตอร์จะเป็นไปโดยอัตโนมัติโดยสมบูรณ์การแยก Node ออกจากคลัสเตอร์เป็นเพียงเรื่องของการลบ Node ที่ไม่จำเป็นหรือ Node ที่ล้มเหลวออกไม่จำเป็นต้องใช้ตรรกะขนาดใหญ่เพื่อแยกการอ่านและเขียนอีกต่อไปศักยภาพในการปรับขนาดสามารถนำไปใช้ได้ทันทีโดยไม่จำเป็นต้องเปลี่ยนตรรกะของแอปพลิเคชัน Galera และ XtraDB เสนอหนึ่งในการป้องกันข้อมูลสูญหายและฐานข้อมูลที่ไม่สอดคล้องกันที่ดีที่สุดเนื่องจากไม่มีความล่าช้าในการจำลองข้อมูลหาก Node คลัสเตอร์ตัวใดตัวหนึ่งล้มเหลวแอปพลิเคชันผู้ใช้จะมองไม่เห็นและจะยังคงให้บริการผู้ใช้ต่อไปโดยใช้ Node อื่นที่อาจอยู่ในศูนย์ข้อมูลอื่นด้วย