คู่มือ Auto-Clustering of Instances สำหรับ การตั้งค่า Application
คู่มือนี้เรียบเรียงสำหรับ Ruk-Com PaaS หน้าจอและตัวเลือกอาจแตกต่างตามเวอร์ชันและสิทธิ์ของบัญชี
ตรวจสอบ Environment, Region, สิทธิ์บัญชี และสำรองค่าปัจจุบันก่อนดำเนินการกับระบบจริง
คำสั่ง ชื่อเมนู พารามิเตอร์ และค่าตัวอย่างในกรอบ Code คงรูปแบบตามระบบเพื่อให้คัดลอกและตรวจสอบได้ถูกต้อง
การจัดกลุ่มอินสแตนซ์อัตโนมัติผ่านตัวช่วยสร้างโทโพโลยี
แพลตฟอร์มดังกล่าวจัดให้มีการจัดกลุ่มอัตโนมัติตามความต้องการสำหรับเทมเพลตที่ได้รับการจัดการบางส่วนระบบอัตโนมัติดังกล่าวช่วยลดความยุ่งยากและเร่งความเร็วในการสร้างคลัสเตอร์ที่พร้อมสำหรับการผลิตที่เชื่อถือได้สำหรับโครงการของคุณ
ด้านล่างนี้เราจะพิจารณาประเด็นต่อไปนี้:
- สแต็กที่รองรับ(พร้อมข้อมูลเฉพาะของการจัดกลุ่ม)
- การจัดการการจัดกลุ่มอัตโนมัติ
- การใช้งานสคริปต์บนคลาวด์
เทมเพลตที่รองรับ Auto-Clustering
ปัจจุบันเทมเพลตต่อไปนี้รองรับฟีเจอร์การทำคลัสเตอร์ที่เพิ่มใหม่ (และจะมีสแต็กเพิ่มมากขึ้นในอนาคต):
- แอปพลิเคชันเซิร์ฟเวอร์-Tomcat/TomEE,GlassFish,ปายรา,เจนกินส์,WildFly
- ฐานข้อมูล SQL-MySQL,MariaDB,Percona,PostgreSQL
- ฐานข้อมูล NoSQL-โซฟาเบด,เรดิส,เปิดการค้นหา
- เซิร์ฟเวอร์จัดเก็บข้อมูล-คอนเทนเนอร์จัดเก็บข้อมูลที่ใช้ร่วมกัน
เคล็ดลับ:ผู้ให้บริการโฮสต์บริการเฉพาะของคุณสามารถกำหนดค่าและใช้การจัดกลุ่มอัตโนมัติสำหรับสแต็กเพิ่มเติมบางส่วนที่ไม่ได้กำหนดไว้ในรายการ
Tomcat/TomEE
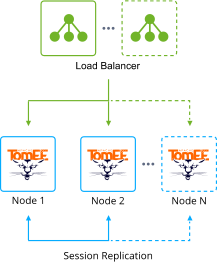
คลัสเตอร์ Tomcat/TomEE ที่พร้อมใช้งานสูงซึ่งสามารถปรับสมดุลโหลดระหว่าง Node ประมวลผลเพื่อเพิ่มประสิทธิภาพและความยืดหยุ่นการใช้งานจัดให้มีการจำลองเซสชันการจำลองแอตทริบิวต์บริบทและการ Deploy ไฟล์ WAR ทั่วทั้งคลัสเตอร์
บันทึก:ที่การจัดกลุ่มอัตโนมัติคุณลักษณะสำหรับ Tomcat และ TomEE พร้อมใช้งานตั้งแต่เวอร์ชันสแต็กต่อไปนี้:
- Tomcat-10.0.5;9.0.45;8.5.64;7.0.108
- TomEE-9.0.0-M3;8.0.5
GlassFish
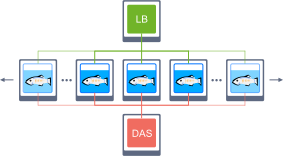
การเชื่อมต่อระหว่างกันของเซิร์ฟเวอร์ GlassFish ด้วยการจำลองเซสชันที่กำหนดค่าไว้ล่วงหน้าและการปรับสมดุลโหลด
ปายรา
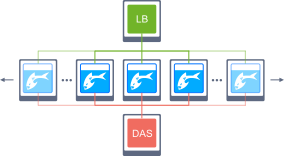
การเชื่อมต่อระหว่างเซิร์ฟเวอร์ Payara ด้วยการจำลองเซสชันที่กำหนดค่าไว้ล่วงหน้าและการปรับสมดุลโหลด
เจนกินส์
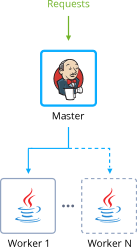
Node หลัก Jenkins ในโหมด master-slave พร้อมด้วยผู้ปฏิบัติงาน Java Engine ที่ปรับขนาดได้อัตโนมัติและปลั๊กอินที่ติดตั้งไว้ล่วงหน้าเพื่อรองรับการสร้างและการ Deploy อัตโนมัติสำหรับการจัดระเบียบไปป์ไลน์การรวมอย่างต่อเนื่อง (CI) และการส่งมอบอย่างต่อเนื่อง (CD)
เรียนรู้เพิ่มเติม »
WildFly
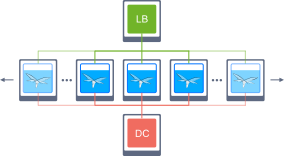
Node WildFly เข้ามาโหมดโดเมนด้วยการทำคลัสเตอร์ที่เปิดใช้งานเพื่อให้มีความพร้อมใช้งานสูงและรับประกันประสิทธิภาพที่ต่อเนื่องของแอปพลิเคชัน Java EE ที่ปรับใช้
เรียนรู้เพิ่มเติม »
MySQL
การทำคลัสเตอร์อัตโนมัติมีให้สำหรับ MySQL เวอร์ชัน 5.7.x และ 8.x เท่านั้น
การจัดกลุ่มระบบฐานข้อมูลอัตโนมัติพร้อมการจำลองแบบที่กำหนดค่าไว้ล่วงหน้าและการค้นพบ Node อัตโนมัติ
คุณสามารถเลือกได้ตามความต้องการของคุณโครงการประเภทดังต่อไปนี้:
- Primary-Primaryกับมัธยมศึกษาตอนปลายพิเศษ
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วยฐานข้อมูลหลักสองฐานข้อมูลที่เชื่อมต่อถึงกันในระหว่างการปรับขนาดแนวนอนคลัสเตอร์จะถูกขยายพร้อมกับ Node รองเพิ่มเติม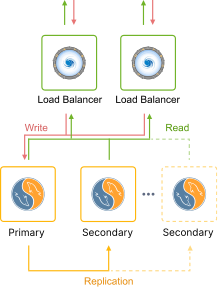
- Primary-Secondaryกับมัธยมศึกษาตอนปลายพิเศษ
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วยฐานข้อมูลหลักและฐานข้อมูลรองหนึ่งฐานข้อมูลในระหว่างการปรับขนาดแนวนอนคลัสเตอร์จะถูกขยายพร้อมกับ Node รองเพิ่มเติม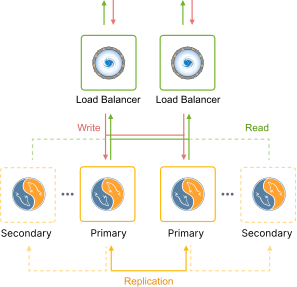
MariaDB
การทำคลัสเตอร์อัตโนมัติมีให้สำหรับเวอร์ชัน 10.x MariaDB เท่านั้น
การจัดกลุ่มระบบฐานข้อมูลอัตโนมัติพร้อมการจำลองแบบที่กำหนดค่าไว้ล่วงหน้าและการค้นพบ Node อัตโนมัติ
คุณสามารถเลือกได้ตามความต้องการของคุณโครงการประเภทดังต่อไปนี้:
- Primary-Primaryกับมัธยมศึกษาตอนปลายพิเศษ
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วยฐานข้อมูลหลักสองฐานข้อมูลที่เชื่อมต่อถึงกันในระหว่างการปรับขนาดแนวนอนคลัสเตอร์จะถูกขยายพร้อมกับ Node รองเพิ่มเติม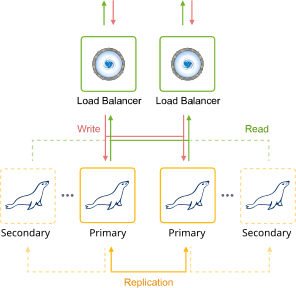
- Primary-Secondaryกับมัธยมศึกษาตอนปลายพิเศษ
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วยฐานข้อมูลหลักและฐานข้อมูลรองหนึ่งฐานข้อมูลในระหว่างการปรับขนาดแนวนอนคลัสเตอร์จะถูกขยายพร้อมกับ Node รองเพิ่มเติม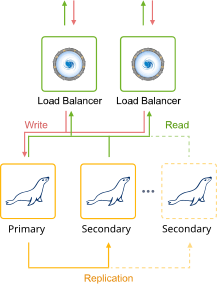
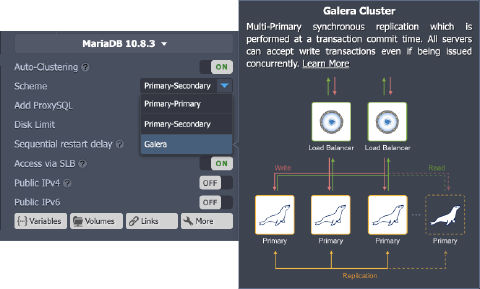
- Galeraกลุ่ม
เซิร์ฟเวอร์ทั้งหมดสามารถรับการอัปเดตได้แม้ว่าจะมีการออกพร้อมกันก็ตาม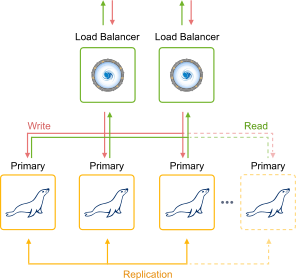
Percona
การจัดกลุ่มระบบฐานข้อมูลอัตโนมัติพร้อมการจำลองแบบที่กำหนดค่าไว้ล่วงหน้าและการค้นพบ Node อัตโนมัติ
คุณสามารถเลือกได้ตามความต้องการของคุณโครงการประเภทดังต่อไปนี้:
- Primary-Primaryกับมัธยมศึกษาตอนปลายพิเศษ
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วยฐานข้อมูลหลักสองฐานข้อมูลที่เชื่อมต่อถึงกันในระหว่างการปรับขนาดแนวนอนคลัสเตอร์จะถูกขยายพร้อมกับ Node รองเพิ่มเติม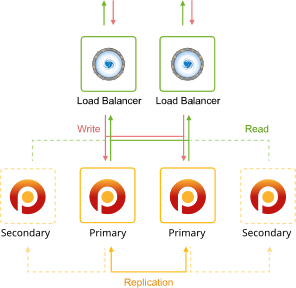
- Primary-Secondaryกับมัธยมศึกษาตอนปลายพิเศษ
การจำลองแบบที่กำหนดค่าไว้ล่วงหน้าด้วยฐานข้อมูลหลักและฐานข้อมูลรองหนึ่งฐานข้อมูลในระหว่างการปรับขนาดแนวนอนคลัสเตอร์จะถูกขยายพร้อมกับ Node รองเพิ่มเติม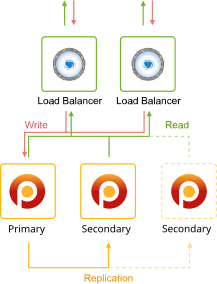
- เอ็กซ์ตร้าดีบีกลุ่ม
โซลูชันการจัดกลุ่มฐานข้อมูลที่รับประกันความพร้อมใช้งานสูงป้องกันการหยุดทำงานและการสูญหายของข้อมูลและมอบความสามารถในการปรับขนาดเชิงเส้นสำหรับ Environment ที่กำลังเติบโต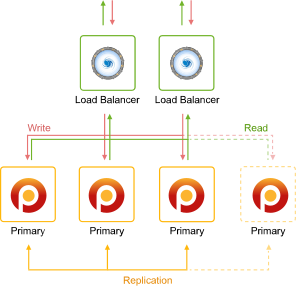
PostgreSQL
คลัสเตอร์ฐานข้อมูล PostgreSQL ที่กำหนดค่าไว้ล่วงหน้าพร้อมการจำลองแบบปฐมภูมิ-รองแบบอะซิงโครนัสและการเพิ่ม Node ใหม่ลงในคลัสเตอร์โดยอัตโนมัติ (เป็น Node รอง)
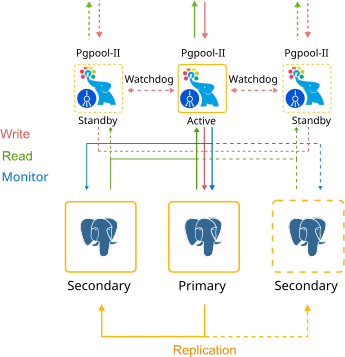
เรียนรู้เพิ่มเติม »
โซฟาเบด
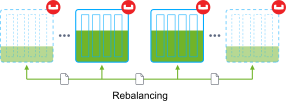
เซิร์ฟเวอร์ Couchbase ที่เชื่อมต่อถึงกันโดยอัตโนมัติพร้อมการปรับขนาดอัตโนมัติและการปรับสมดุลที่กำหนดค่าไว้ล่วงหน้าเพื่อให้มีระบบจัดเก็บข้อมูลที่พร้อมใช้งานสูงเพียงระบบเดียว
เรดิส
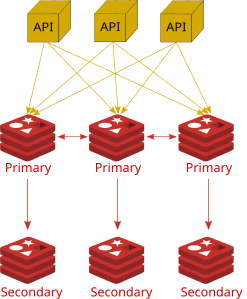
การทำให้เป็นอัตโนมัติสำหรับการใช้งานแบบกระจายของ Redis Cluster ซึ่งเป็นที่จัดเก็บโครงสร้างข้อมูลในหน่วยความจำแบบโอเพ่นซอร์สโดยปกติจะใช้สำหรับการแคชการจัดเก็บข้อมูลเป็นนายหน้าข้อความและสำหรับงานอื่นๆโทโพโลยีที่ให้มาประกอบด้วยเซิร์ฟเวอร์หลักอย่างน้อยสามเซิร์ฟเวอร์โดยแต่ละเซิร์ฟเวอร์มี Node รองเพื่อให้แน่ใจว่ามีการกระจายโหลดการอ่านและการกู้คืนอัตโนมัติหากเซิร์ฟเวอร์หลักหยุดทำงาน
เปิดการค้นหา
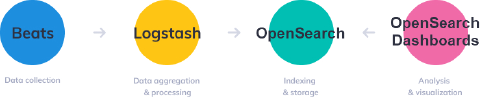
การจัดกลุ่มอัตโนมัติของเครื่องมือค้นหาแบบโอเพ่นซอร์สที่ขับเคลื่อนโดยชุมชนซึ่งมีการค้นหาข้อความแบบเต็มแบบกระจายและมีความสามารถหลายผู้เช่าโซลูชันมีการตั้งค่าในตัวเพื่อเพิ่มแดชบอร์ด OpenSearchสำหรับการแสดงภาพข้อมูลและล็อกสแตชสำหรับการประมวลผลบันทึก
คอนเทนเนอร์จัดเก็บข้อมูลที่ใช้ร่วมกัน
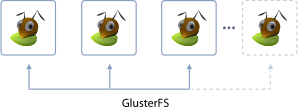
คลัสเตอร์พื้นที่จัดเก็บข้อมูลที่กำหนดค่าโดยอัตโนมัติและเชื่อถือได้ (ปริมาณการจำลอง) โดยอิงตามคลัสเตอร์โซลูชันที่รับประกันความปลอดภัยของข้อมูลในกรณีที่ Node หนึ่งหรือหลาย Node ล้มเหลวออโต้เอฟเอสไคลเอ็นต์จะสลับไปใช้อินสแตนซ์ที่ทำงานโดยอัตโนมัติทำให้มีพื้นที่จัดเก็บข้อมูลมีความพร้อมใช้งานสูง
การจัดการการจัดกลุ่มอัตโนมัติ
- ที่การจัดกลุ่มอัตโนมัติสามารถเปิดใช้งานคุณสมบัติสำหรับกลุ่ม Node ผ่านตัวสลับชื่อเดียวกันในส่วนกลางของวิซาร์ดโทโพโลยี (ถ้ามีสำหรับสแต็กที่เลือก).

เคล็ดลับ:ขึ้นอยู่กับการดำเนินการเฉพาะการจัดกลุ่มอัตโนมัติตัวเลือกสามารถเป็น:
- เปิดใช้งานบังคับ (เช่นสำหรับโซฟาเบดฐานข้อมูล)
 * มาพร้อมกับการตั้งค่าเพิ่มเติมบางอย่าง (เช่นรูปแบบคลัสเตอร์และตัวจัดสรรภาระงาน ProxySQL สำหรับMySQLฐานข้อมูล)
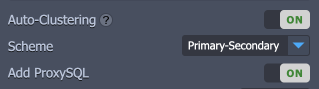 * ถูกจำกัดโดยจำนวน Node ขั้นต่ำ/สูงสุดและ/หรือโหมดการปรับขนาด (เช่นสำหรับMariaDB Galeraพิมพ์)
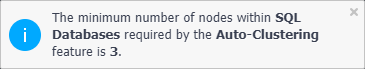
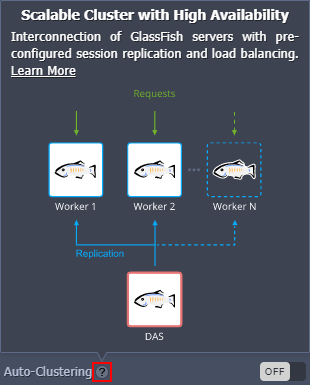
- หากต้องการรับข้อมูลเพิ่มเติมเกี่ยวกับคลัสเตอร์ที่จะสร้างคุณสามารถวางเมาส์เหนือเครื่องหมายคำถามที่อยู่ถัดจากตัวสลับได้ภายในกรอบป๊อปอัปที่เหมาะสมคุณจะพบคำอธิบายสั้นๆซึ่งโดยปกติจะเสริมด้วยโครงร่างโทโพโลยีและลิงก์ไปยังภาพรวมโดยละเอียดเพิ่มเติม
เคล็ดลับ:ข้อมูลเพิ่มเติมเกี่ยวกับคลัสเตอร์ฐานข้อมูลประเภทต่างๆสามารถดูได้โดยการวางเมาส์เหนือประเภทที่เหมาะสมโครงการ::
- ส่วนการตั้งค่าอื่นๆก็ได้กำหนดค่าแล้วเช่นเดียวกับ Environment ปกติใดๆ
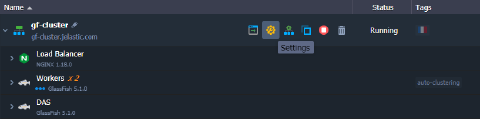
บันทึก:หลังจากกำหนดค่าแล้วการจัดกลุ่มอัตโนมัติไม่สามารถปิดใช้งานได้จากวิซาร์ดโทโพโลยี
- หากจำเป็นคุณสามารถติดตามการกำหนดค่าคลัสเตอร์ผ่านบันทึก Cloud Scripting (นำเข้า> JPS > ดูบันทึก) ในแดชบอร์ด:
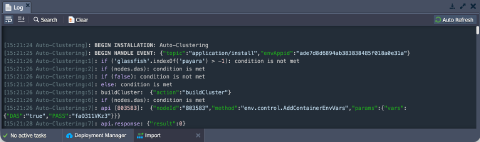 ตัวอย่างเช่นคุณสามารถใช้ข้อมูลนี้เพื่อแก้ไขข้อบกพร่องขณะพัฒนาโซลูชันแบบแพ็กเกจด้วย Cloud Scripting ซึ่งใช้ฟีเจอร์การทำคลัสเตอร์อัตโนมัติ
การตั้งค่าการทำคลัสเตอร์อัตโนมัติด้วย Cloud Scripting
เพื่อกำหนดการตั้งค่าการจัดกลุ่มอัตโนมัติในของคุณเจพีเอสโซลูชั่นใหม่กลุ่มสามารถใช้ทรัพย์สินได้ตัวอย่างเช่น:
- เปิดหรือปิดใช้งานการจัดกลุ่มอัตโนมัติสำหรับเลเยอร์ที่ต้องการ
json.json
"nodeGroup": "couchbase",
"cluster": true | false
- สามารถจัดเตรียมพารามิเตอร์เพิ่มเติมสำหรับการทำคลัสเตอร์อัตโนมัติได้ด้วยวิธีต่อไปนี้ (เช่นจำเป็นต้องเลือกโครงร่างคลัสเตอร์ฐานข้อมูล):
json.json
"nodeGroup": "mysql",
"cluster": {
  "scheme": "master"
}
- หากจำเป็นรายการ JPS เริ่มต้นที่มีขั้นตอนการทำคลัสเตอร์สามารถแทนที่ด้วยรายการที่กำหนดเองได้:
json.json
"nodeGroup": "mysql",
"cluster": {
 "jps": "http://.../custom-manifest.jps",
 "settings": {
   "scheme": "master"
 }
}
- ขึ้นอยู่กับข้อกำหนดของคลัสเตอร์เฉพาะอาจจำเป็นต้องมีข้อจำกัดโทโพโลยีบางประการ (เช่นจำนวน Node ขั้นต่ำ/สูงสุดโหมดการปรับขนาดฯลฯ) ดำเนินการผ่านทางการตรวจสอบคุณสมบัติ.
พารามิเตอร์นี้สามารถระบุสำหรับแพ็คเกจ JPS ใดก็ได้ตรวจสอบตัวอย่าง YAML ด้านล่าง:
yaml
type: install
name: Validation
nodes:
 image: alpine
 nodeGroup: cp
 count: 2
 validation:
   minCount: 2
   maxCount: 3
   scalingMode: stateful
แค่นั้นแหละ! ตอนนี้คุณสามารถใช้โซลูชันการจัดกลุ่มอัตโนมัติที่แพลตฟอร์มรองรับได้อย่างง่ายดายรวมทั้งได้รับประโยชน์ทั้งหมดจากการใช้งานเฉพาะด้าน